
GeMTeX-Projekt erfolgreich: Über 20.000 annotierte Dokumente für die medizinische Forschung verfügbar
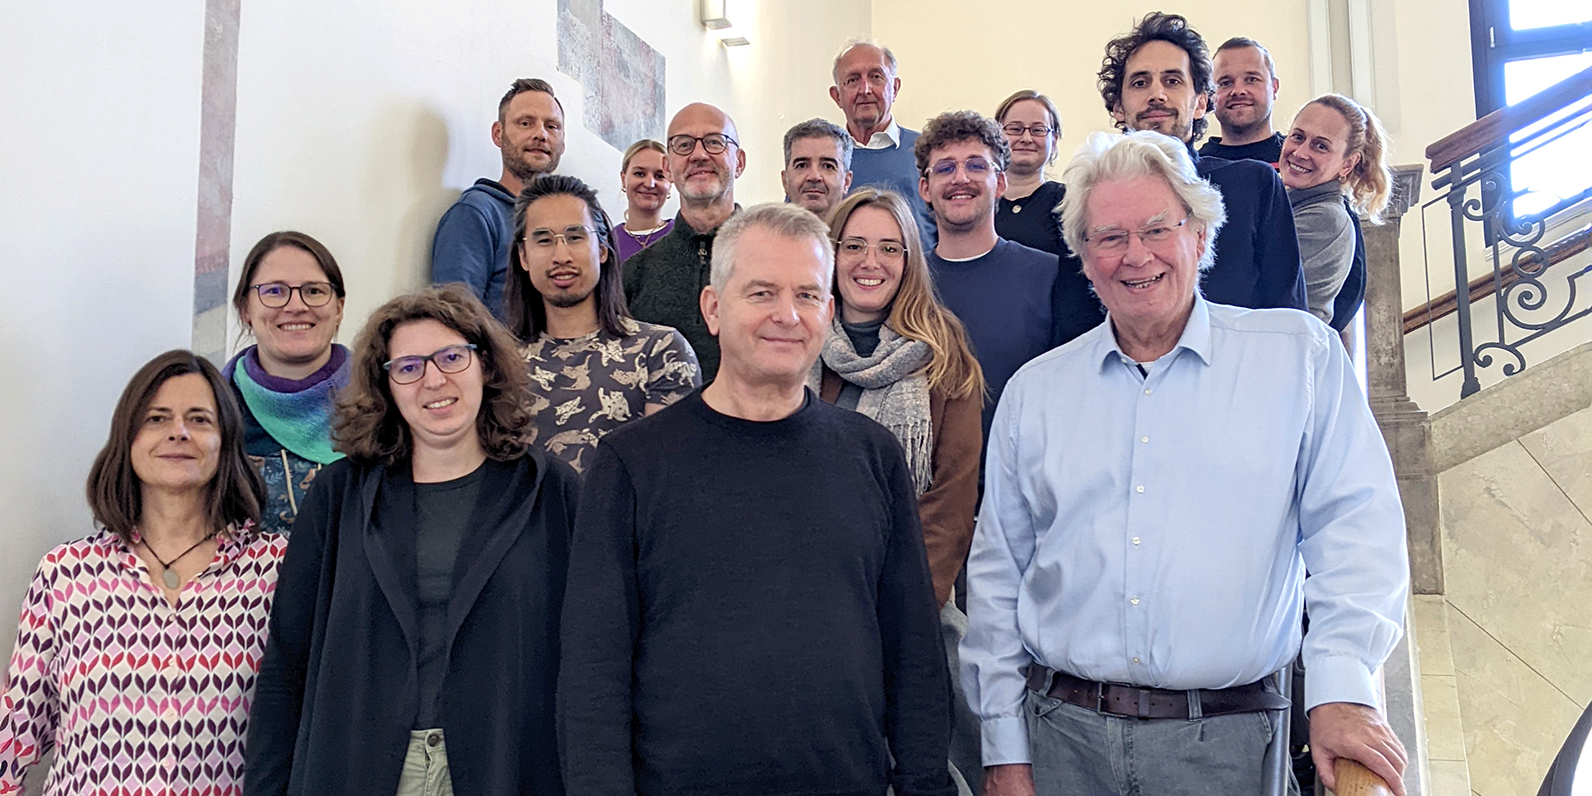
GeMTeX-Abschlussmeeting in Leipzig am 19./20. Oktober 2026
Klinische Dokumente aus der Patientenversorgung für die Forschung datenschutzkonform nutzbar machen: An diesem Ziel hat das Team der MII-Methodenplattform GeMTeX in den vergangenen drei Jahren intensiv gearbeitet. Beim Abschlusstreffen am 19. und 20. Oktober 2026 in Leipzig haben sich rund 20 Projektmitarbeitende getroffen, um die Ergebnisse zusammenzuführen, wissenschaftliche Publikationen vorzubereiten und Bilanz zu ziehen.
Wissenschaftliche Ergebnisse und technische Integration
Im Rahmen des GeMTeX-Projektes wurden von Mai 2023 bis Ende 2026 an sechs universitätsmedizinischen Standorten Dokumente aus der klinischen Routineversorgung de-identifiziert und von angehenden Medizinerinnen und Medizinern annotiert. Dabei wurden Informationen, die Rückschlüsse auf Personen oder Orte ermöglichen, unkenntlich gemacht und die Texte mit Metadaten zu ihrem Inhalt angereichert, um sie für die Forschung und Anwendungen Künstlicher Intelligenz (KI) nutzbar zu machen.
Am ersten Tag des Abschlussmeetings standen die wissenschaftlichen Publikationen im Mittelpunkt, die zu den Arbeiten in GeMTeX veröffentlicht werden sollen.
Im Laufe des Projekts wurden unter anderem Werkzeuge und Plattformen für die De-Identifikation und Annotation weiterentwickelt, technische Prozesse zur Bereitstellung klinischer Dokumente etabliert und Richtlinien für die semantische Annotation medizinischer Texte erarbeitet.
In den kommenden Wochen bereitet das Projektteam diese vielfältigen Ergebnisse in wissenschaftlichen Publikationen auf, um sie der Fachcommunity zugänglich zu machen.
Lessons Learned und Bilanz aus drei Jahren Projektarbeit
Der zweite Tag widmete sich den Erfahrungen aus den Annotationsarbeiten, den zentralen Lessons Learned und der Zusammenfassung der Projektergebnisse. Trotz Herausforderungen bei der Planung, der Rekrutierung und der technischen Integration zieht das Team eine positive Bilanz.
Insgesamt sind in der Projektlaufzeit über 20.000 Dokumente mit fast 7 Millionen Tokens manuell annotiert. So ist mit dem GeMTeX-Korpus bei Weitem das größte klinische Textkorpus deutscher Sprache entstanden, das für die wissenschaftliche Analyse medizinischer Texte und die Entwicklung datenbasierter Anwendungen zur Verfügung steht.
Zu den zentralen Erfolgen zählen außerdem die Anpassung und Weiterentwicklung der Annotationsplattform INCEpTION, die Entwicklung einer Pipeline zur De-Identifikation klinischer Dokumente, die erste großangelegte konzeptbasierte Textannotation mit SNOMED CT und die Integration der Projektergebnisse in den Kerndatensatz der Medizininformatik-Initiative (MII). Mit dem neuen Kerndatensatzmodul „Dokument“ können die Texte in die Datenintegrationszentren (DIZ) sowie in das Forschungsdatenportal für Gesundheit (FDPG) integriert werden, um sie für die Forschung nutzbar zu machen. Der Partner ZB MED hat GeMTeX in seinem Health Study Hub verlinkt, sodass das Korpus zusammen mit Informationen zu seiner Nutzung von Wissenschaftlerinnen und Wissenschaftlern leicht gefunden werden kann.
Eine Grundlage für die weitere Forschung
„Das GeMTeX-Korpus hat nach internationalem Maßstab eine herausragende Qualität,“ fasste Prof. Dr. Martin Boeker, Projektleiter des GeMTeX-Projektes, zusammen. Dies sei besonders dem wissenschaftlich fundierten Vorgehen, der hohen Übereinstimmung zwischen den Annotatorinnen und Annotatoren sowie der strengen Einhaltung von Datenschutzstandards zu verdanken, die das Korpus nachhaltig verwertbar machen.
Auch über das Projektende hinaus wird das GeMTeX-Team seine Ergebnisse in die wissenschaftliche Community tragen: Neben wissenschaftlichen Publikationen sind dafür Workshops auf Fachveranstaltungen wie der Medical Informatics Europe (MIE) und der Jahrestagung der Deutschen Gesellschaft für Medizinische Informatik, Biometrie und Epidemiologie (GMDS) geplant.
Zahlreiche Anschlussprojekte zu klinischen Textkorpora
Mit dem Abschluss von GeMTeX wird die Forschung an klinischen Textkorpora im Umfeld des Projekts fortgeführt. Zwei Vorhaben wurden im Rahmen der DFG-Ausschreibung „Datenkorpora für Künstliche Intelligenz“ bewilligt: In Leipzig soll ab 2027 mit LIFETEX ein Textkorpus aus Dokumenten der LIFE-Studie zur Erforschung von Zivilisationserkrankungen verfügbar gemacht und mit Daten des LIFE-Forschungszentrums verknüpft werden. Das Heidelberger Projekt CARDIO++ erweitert das bereits verfügbare Textkorpus CARDIO:DE und treibt die Forschung zu KI-Anwendungen im Bereich der kardiovaskulären Medizin voran.
Ebenfalls 2027 startet in Leipzig das BMFTR-Datennutzungsprojekt PARADE. Mithilfe großer Sprachmodelle sollen darin unerwünschte Arzneimittelereignisse und Wechselwirkungen von Medikamenten erkannt werden. Darüber hinaus fördert das sächsische Netzwerk KIMed – Netzwerk für Künstliche Intelligenz in der Medizin einen Natural Language Processing (NLP)-Anwendungsfall, der demonstrieren soll, wie sich Methoden aus GeMTeX in einer sicheren Forschungsumgebung (Secure Processing Environment, SPE) einsetzen lassen.
Aktuelle Publikation:
Developing the German Medical Text Corpus (GeMTeX): Legal Compliance and Semantic Enrichment (Hofenbitzer et al., LREC 2026)
Zugang zum GeMTeX-Korpus: